samza是一个分布式的流式数据处理框架(streaming processing),它是基于Kafka消息队列来实现类实时的流式数据处理的。下面将从为什么需要Samza、Samza一些基本概念、Samza架构、Samza的核心部件(SamzaContainer、Stream、Serialization、Checkpointing、State Management、Windowing、Metrix、JMX)几个部分来介绍。
为什么需要samza
kafka作为一个分布式的消息队列系统,已经实现了流式处理框架底层的许多核心基础架构,把消息串联流动起来就是Streaming了。kafka相关内容可以参考另一篇博客kafka介绍。
但是要构建一个可用的流式数据处理框架,还是有许多事情要做。例如生产者和消费者进程的管理,作业调度和容错处理,辅助工具和监控管理手段,更友好方便的用户接口等等,本质上说,Samza是在消息队列系统上的更高层的抽象,是一种应用流式处理框架在消息队列系统上的一种应用模式的实现。
需要解决的问题
比如分区:如何划分流?如何划分处理器?如何管理状态,其中状态本质上是指在处理器中维护的介于消息之间的东西,或者如果每次有消息到达的时候,计数器就会加1,那么它也可以是像总数这样的东西。如何重新处理?
至于失败语义,我们会得到至少一次,或者至多一次,或者恰好一次消息,也有不确定性。如果流处理器与另一个系统交互,无论它是个数据库,还是依赖于时间或者消息的顺序,如何处理那些真正决定最终输出结果的数据?
核心思想
Samza的一个job的基本处理流程是一个用户任务从一个或多个输入流中读取数据,再输出到一个或多个输出流中,具体映射到kafka上就是从一个或多个topic读入数据,再写出到另一个或多个topic中去。多个job串联起来就完成了流式的数据处理流程。
这种模式其实有点像MapReduce的过程,stream输入部分由kafka的partition决定了分区和task数目,类似于一个Map过程,输出时由用户task指定topic和分区(或者框架自动由Key决定分区),这相当于一次shuffle的过程,下一个job读取新的stream时,可以认为是一个reduce,也可以认为是下一个map过程的开始。
不同之处在于job之间的串联无需等待上一个job的结束,类实时的消息分发机制决定了整个串联的job是连续不间断的,亦即流式的。
应用场景举例
- 流处理方面
- 处理topic:最常见的对kafka中的topic进行消费,然后对消息进行处理,生成新的topic发送到kafka。
- 镜像topic:对kafka中的数据流直接进行消费,然后不经过处理,直接在另一个kafka集群上生成一个镜像的kafka topic。
- 关联topic:利用samza的状态管理,可以将kafka中的两个topic进行关联。例如,广告的点击topic和转化topic可以通过samza的状态管理中的key-value存储,然后merge起来。
- 有状态的分布式事件驱动服务
- 有状态的事件驱动服务的状态管理,利用远程数据库或者系统内部维护状态。利用远程数据库会有I/O或者CPU瓶颈,系统内部维护状态在分布式的情况下容错处理实现也比较麻烦。而Samza集成本地的key-value数据库RocksDB,state的change会生成changelog stream放在kafka上,容错性好。
特性
Samza是一个流式计算框架,它有以下特性:
- 简单的API:和绝大多数低层次消息系统API不同,相比MapReduce,Samza提供了一个非常简单的“基于回调(callback-based)”的消息处理API
- 管理状态:Samza管理快照和流处理器的状态恢复。当处理器重启,Samza恢复其状态一致的快照。Samza的建立是为了处理大量的状态
- 容错性:当集群中有一台机器宕机了,基于Yarn管理的Samza会立即将你的任务导向另一台机器;
- 持久性:Samza通过Kafka保证消息按顺序写入对应分区,并且不会丢失消息;
- 扩展性:Samza在每一层都做了分区和分布。Kafka提供了顺序的、分区、可复制的、容错的流。YARN则为Samza的运行提供了一个分布式环境
- 可插拔:虽然Samza在Kafka和YARN的外部工作,但是Samza提供了可以让你在其它消息系统和执行环境里运行的可插拔的API
- 处理器隔离:运行在YARN上的Samza同样支持Hadoop安全模型以及通过linux CGroups进行资源隔离
Samza区别于其他框架的几个方面:
- Samza支持局部状态的容错。状态自己作为一个流被构造。如果因为机器宕机本地状态丢失,那么状态流会回放重新存储它
- 流是有序、分区的、可回放的并且是容错的
- YARN用来处理隔离、安全和容错
- 任务之间是解耦的:如果有一个任务慢了并且造成了消息的积压,系统其它部分不会受到影响;
一些基本概念
流(Streams)
Samza处理流。流是由一定数量的类型或类别相似的不可变消息组成。
- kafka里,流是一个topic(话题)
- 数据库里,我们可以通过消费从一个表里更新操作读取一个流
- hadoop里,我们可能跟踪在hdfs上的一个目录下的文件
作业(job)
Samza的jobs 是将输入流进行逻辑处理,然后转化成输出流的程序。
为了扩展流处理器的吞吐量,stream拆分成Partitions
Streams–>Partitions
job拆分更小的并行单元任务Tasks
job–>tasks
分区(Partitions)
每个流都被分割成一个或多个分区,并且在流里的每一个分区都总是一个有序的消息序列。每个消息在这个序列里有一个被叫做offset(中文称它为偏移量),它在每一个分区里都是唯一的。这个偏移量可以是一个连续的整数、字节偏移量或者字符串,这取决于底层的系统实现了。
当有一个消息加入到流中,它只会追加到流的分区中的一个。这个消息通过写入者带着一个被选择的key分配到它对应的分区中。举个例子,如果用户id被用作key,那么所有和用户id相关的消息都应该追加到这个分区中。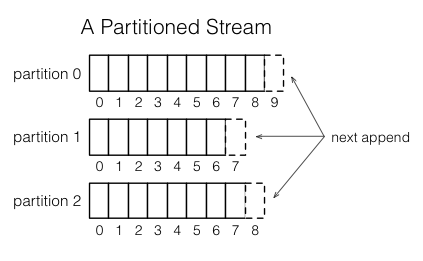
任务(task)
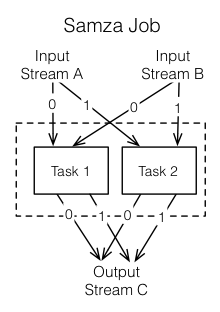
一个Job通过把他分割成多个任务Task进行扩展。每个任务Task消费来自一个Partitions的数据。
按照消息的偏移,一个任务按序处理来自它的输入分区的消息。分区之间没有定义顺序,这就允许每一个任务独立执行。YARN调度器负责分发任务给一台机器,所以作为一个整体的工作Job可以分配到多个机器并行执行。
在一个Job中任务Task的数量是由输入分区决定的(也就是说任务数目不能超过分区数目,否则就会存在没有输入的任务)。可是,你能改变分配给Job的计算资源(比如内存、cpu核数等)去满足job的需要,可以参考下面关于container的介绍。
另外一个值得注意的是分配给task的分区的任务绝不会改变:如果有一个任务在一台失效的机器上,这个task会被在其它地方重启,仍然会消费同一个流的分区。
Dataflow Graphs
我们能组合多个Jobs去创建一个数据流图(DAG 有向无环图),其中节点表示包含数据的流,而边则是进行数据传输。这个组合纯粹是通过Jobs作为输入和输出的流来完成。这些Jobs也是解耦的:他们不需要基于相同的代码库,并且添加、删除或者重启一个下游任务不会影响上游的任务。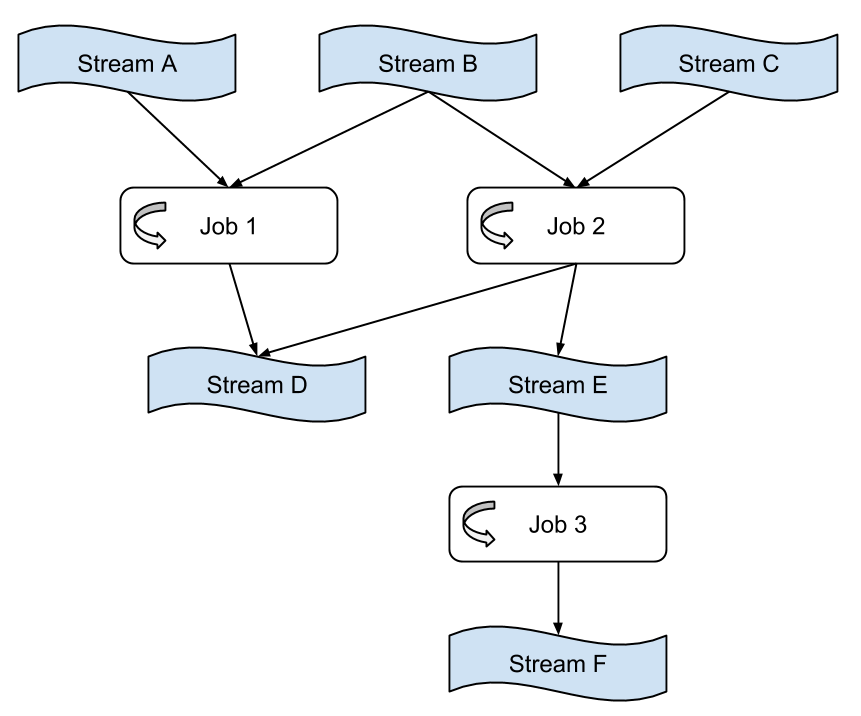
其他概念
- Containers——分区Partitions和任务Tasks都是并行的逻辑单元。Containers是物理的并行单元,并且一个容器本质上是一个Unix进程(或者Linux cgroup)。每个容器跑着一个或多个Tasks。Tasks的数量是从输入的分区数自动确定和固定下来的,但是容器的数量(CPU、内存资源)是在运行时用户设定的并且能在任何时刻改变。
- TaskRunner——TaskRunner是Samza的流处理容器。它负责启动、执行以及关闭一个或多个StreamTask实例。
- “检查点(Checkpointing)”——检查点通常用于故障恢复,实现“at least once”语义。如果一个taskrunner由于某种原因宕掉了(比如,硬件故障),当重新启动时,它应该使用最后离开时的消息——这是通过检查点实现的。
- 状态管理(State Management)——需要在不同的消息处理之间传递的数据称之为状态——它可以是保存一个总数那样简单的东西,也可以是复杂得多的东西。Samza允许任务维持一种持久可变且可查询的状态,而且,它与每个任务在物理上处于同一位置。状态需要具备高可用性:如果出现任务失败的情况,它可以在任务故障转移到另一台机器时还原。
- 周期任务(Windowing)——有一些需要周期执行的任务
- 监控相关(Metrix&&JMX)——当在生产中运行stream process过程,用Metrix(度量)来跟踪job的运行,Metrix有kafka流或者JMX的方式。
在Samza架构之后,会具体介绍这些概念。
Samza 架构
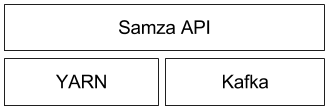
Samza是由以下三层构成:
- 数据流层(A streaming layer):分布式消息中间件Kafka
- 执行层(An execution layer):Hadoop资源调度管理系统YARN
- 处理层(A progressing layer):Samza API
kafka
kafka相关内容可以参考另一篇博客kafka介绍。
Kafka是一个分布式发布/订阅消息队列系统,它支持at-least once通信保障(即系统保证没有信息丢失,但是在某些故障情况下,消费者可能收到超过一条同样的信息)和高度可用的分区特性(即使一台机器宕机了,分区依然是可用的)。
每一条数据流被称为一个topic。每一个话题都在多台被称作broker的机器上进行分区和复制。当一个生产者发送一条消息给一个话题,它会提供一个key,这个key被用来决定这条消息应该被发送到哪一个分区。生产者发送信息而Kafka的broker则接收和存储它们。Kafka的消费者能通过在一个话题的所有分区上订阅消息来读取消息。
Kafka有一些有趣的特点:
- 同一个key的所有消息都被划分到同一个分区,这就意味着如果你想要读到一个特定用户的所有消息,你只要从包含这个用户id的分区读取即可,而不是整个topic(假设把用户id用作key)
- 一个topic的分区是按顺序到达的一序列消息,所以你可以通过单调递增偏移量offset来引用任何消息(就好比放一个索引到一个数组里);这也意味着broker不需要跟踪被一个特定的消费者读取的消息,为什么呢?因为消费者保存了消息的偏移量offset能够跟踪到它。然后我们知道的是带着一个比当前偏移量小的消息是已经被处理过的,而每一个带着更大偏移量的消息还没有被处理过。
YARN
YARN有三个组成部分:资源管理器(ResourceManager)、节点管理器(NodeManager)和应用管理器(ApplicationMaster)。
- NodeManager:在一个YARN网格里,每一台机器上都跑着NodeManager,它负责在所在的机器上启动进程。
- ResourceManager与所有的NodeMananger交互告诉它们跑什么应用,反过来NodeManager也会告诉ResourceManager它们希望什么时间在集群里跑这些东东。
- ApplicationMaster让特定应用的代码跑在YARN集群上,它负责管理应用的负载、容器(通常是UNIX进程),并且当其中一个容器失败时发出通知。
Samza提供了一个YARN ApplicationMaster和一个开箱即用的YARN Job运行器。如图所示(不同的颜色表示不同的机器)
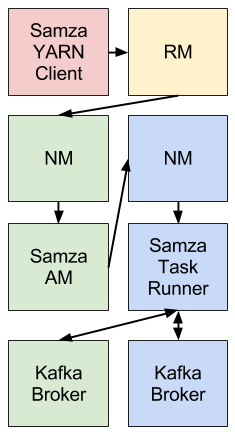
Samza的客户端告诉YARN的RM(ResourceManager,以下简称RM)运行一个新的Job,RM会告诉YARN的一个NodeManager(简称NM)为Samza的ApplicationMaster(AM)在集群里分配空间。一旦NM分配了空间,就会启动这个Samza的AM。AM开始后,它会向RM请求运行SamzaContainers所需的YARN containers。RM和NMs一起为containers分配空间。一旦空间被分配,NMs就会开启Samza containers。
YARN启动并且监控一个或者多个SamzaContainers,并且你的处理逻辑代码(使用StreamTask API)在这些容器里运行。这些Samza 流任务的输入和输出都来自Kafka的Brokers(通常他们都是作为YARN NMs位于同台机器)
通过对topic的分区,将数据流处理拆解到任务中以及在多台机器上并行执行任务,使得Samza具有很高的消息吞吐量。通过结合YARN和Kafka,Samza实现了高容错:如果一个进程或者机器失败,它会自动在另一台机器上重启它并且继续从消息终端的地方开始处理,这些都是自动化的。
SamzaContainer
SamzaContainer负责管理一个或多个StreamTask实例的启动,执行和关闭。每个SamzaContainer通常在独立的Java虚拟机上运行。一个Samza job可以由几个SamzaContainers组成,并可以在在不同的机器上运行。
当SamzaContainer启动时,它按照顺序执行以下操作:
- 获取每个输入流的分区的最后一个checkpoint记录的偏移量,并从此位置开始处理消息
- 作为消费者,对于每一个输入流分区创建一个“reader”线程
- 启动度量监控器(metrics reporters),监控度量指标
- 启动定时器检查站(checkpoint timer),每隔一段时间,保存任务的输入流中的偏移量
- 如果定义了任务的windows方法,将启动一个窗口定时器(window timer),触发任务的windows方法
- 为每个kafka输入流的分区实例化和初始化StreamTask(即调用InitableTask的init方法)
- 启动事件循环(event loop),从reader线程读取消息,传递到StreamTask
Event Loop
事件循环是container的一个单线程,负责读写消息,传递指标(metrix)、checkpoint周期执行和window周期执行。事件循环的工作原理如下:
- 从传入消息队列获取消息;
- 通过调用process()给适当的任务实例传递信息;
- 如果任务实例实现WindowableTask并且窗口周期时间到了,在该任务实例上调用window();
- 从process()和window()调用适当的SystemProducers输出消息;
- 时间间隔到了,写checkpoint
任务与分区(Tasks and Partitions)
通过前面的介绍可以得知,samza job划分为task,samza stream划分为partition。单个task消费并处理stream中单个partition的消息。
因此,samza job的input stream有多少个partition,就会创建多少个samza task 的实例。
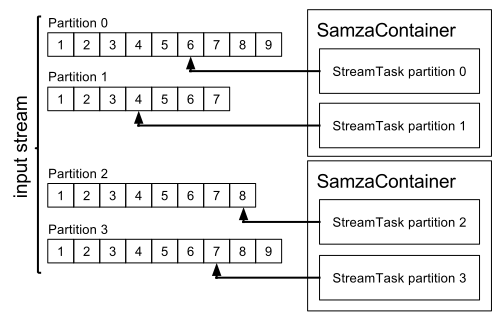
samza stream的partition数量,取决于消费的系统。
例如,如果的数据流是通过kafka系统来实现的,那么数据流的partition数量是kafka的topic的分区数。是你创建kafka队列的时候的cmd决定的。如果cmd中没有指定,那么默认是通过 kafka的服务器端配置中的num.partitions这个阐述。
如果samza job多于一个input stream,那么,对应到Samza job 的task实例,将是所有input stream中partition的最大值。例如:如果一个Samza job从PageViewEvent(12 partition)和ServiceMetricEvent(14 partition),那么,将会产生14个task实例(从0到13)。task实例12和13将只用来读取和ServiceMetricEvent事件,因为PageViewEvent没有对应的partition。
容器和资源分配
task实例的数量由input stream的partition数决定。
SamzaContainer数,是否什么决定的呢?如果使用yarn,容器的数量是由分配给你的CPU和内存资源决定的。
每一个SamzaContainer被设计成只是用一个CPU,因此他用了单线程事件循环的模式。因此,你在开发程序的时候,不要再SamzaContainer创建自己的多线程。如果你需要进行并行,你需要配置一下你的job利用多SamzaContainer。
多个输入流
如果你的工作有多个输入流,Samza提供了一个简单但强大的机制来加入数据从不同的来源:每个任务实例接收消息从一个分区的每个输入流。例如,假设您有两个输入流,A和B,每四个分区。Samza创建了四个任务实例流程,分配分区如下:
| Task instance | Consumes stream partitions |
|---|---|
| 0 | stream A partition 0, stream B partition 0 |
| 1 | stream A partition 1, stream B partition 1 |
| 2 | stream A partition 2, stream B partition 2 |
| 3 | stream A partition 3, stream B partition 3 |
因此,如果想要两个在不同的流中的事件被同样的任务实例处理,需要确保它们被发送到相同的分区号,即使用相同的key发送消息。
Stream
SamzaContainer 是通过 SystemConsumer 与 SystemProducer 接口进行消息得读取与写入。你可以通过这两个接口实现对任何消息系统得整合。
特点:
插件式:开箱即用,Samza实现了对kafka的支持(KafkaSystemConsumer和KafkaSystemProducer)。然而,任何消息总线系统都可以被整合,只要它能提供由Samza所需的接口。
消息类型多样:SystemConsumers和SystemProducers可以读取和写入任何数据类型的消息。
Samza没有规定任何具体的数据模型或序列化格式,具体形式可以由开发人员实现。如果他们只支持byte数组也没有关系——Samza有一个独立的串行化层,将之转化为应用程序代码可以使用对象。
流处理
如果job从多个输入数据流处处理消息,并且所有输入流消息可用,缺省情况下将在一个循环赛的方式逐个处理。
例如,如果一个job需要处理AdImpressionEvent和AdClickEvent的消息,任务实例的process()方法被调用,来处理AdImpressionEvent消息,再处理AdClickEvent消息,然后从AdImpressionEvent处理另一个消息,…,并继续在这两者之间交替处理。
如果流处理系统处理中如果一个输入流没有消息,那么流处理系统将跳过这个输入流进行处理另外一个输入流。同时,还会继续检查空输入流是否有新的消息进来。
MessageChooser
当Samza容器对不同的流分区传入的消息进行处理的时候,它是如何决定要首先处理拿一个?该行为是由一个MessageChooser决定。默认选择器是RoundRobinChooser,但你可以自己实现自定义选择器覆盖它。
实现自己的MessageChooser,你需要实现MessageChooserFactory接口,并在配置文件中设置“task.chooser.class”,并配置您实现的完全类名:
task.chooser.class=com.example.samza.YourMessageChooserFactory
优先输入流
在一定得时间窗口内,可以让一个输入流得处理比另一个输入流得处理有更高得优先级别,我们可以通过设置输入流得优先级别。例如:samza得job需要处理2个输入流,其中一个输入流由实时系统提供消息,另外一个由批处理系统提供处理消息。在这个案例中,我们将给实时输入流提供更高得优先级。可以使实时输入数据流系统不会产生突然变慢得情况。
例如,我们可以再配置文件中设置如下:
systems.kafka.streams.my-real-time-stream.samza.priority=2
systems.kafka.streams.my-batch-stream.samza.priority=1
引导顺序
略
批处理
在某些情况下,可以提高每次从多个分区消费多个消息,从而提高消息得处理能力。 Samza支持这种操作模式,被称为批处理。
例如,如果你想读的100条信息从每个流分区行,你可以使用这个配置参数:
task.consumer.batch.size=100
Serialization
任何消息最终都需要被序列化成字节(通过网络发送或写到本地磁盘),包括读取或写入的流数据或者持久化状态信息存储。序列化和反序列化可能发生在各种地方:
- 在客户端lib库中:例如,从kafka进行生产或者消费支持可插入的序列化。
- 在任务的执行中:你的process程序将原始字节作为inputs与outputs,并进行任何解析和序列化。
- 在两者之间: Samza 提供了一层专门进行序列化与反序列化,叫做SERDE层。
你可以使用任何方式做这块工作;samza不会强加任何特定的数据模型或序列化模式。然而,最合理的做法,通常是使用Samza的SERDE层。
Serde层类型
每个serde通过一个工厂类定义。可以通过实现SerdeFactory接口创建自己的序列化器。以下是Samza自带的serde类型的列表:
| Serde Name | Data Handled |
|---|---|
| string | UTF-8 strings |
| integer | binary-encoded integers |
| serializable | Serializable Object Type |
| long | long data type |
| json | JSON formatted data |
| byte | Plain Bytes (effectively no-op) - Useful for Binary Messages |
| bytebuffer | Byte Buffer |
例如:在配置文件中,定义名为“string”的serde。将用于名为“kafka”的system中对输入流中的key反序列化,并序列化输出流中的key
Checkpointing
Samza提供对流的容错性处理:Samza保证信息不会丢失,即使你的job崩溃,或者是一台机器down掉了,再或是网络故障,还是其他什么地方出了问题。为了提供这种保障,Samza期望的输入流系统,要能以满足以下要求:
- 该流可以分成一个或多个分区。每个分区是独立的,分区的副本在多台机器复制(即使一台机器出现故障,流仍然可用)。
- 每个分区包含在一个固定的顺序的序列消息。每个消息都有一个偏移量,这表明其在该序列的位置。每个分区内消息总是按顺序消费
- 一个Samza作业可以从消息序列的任何位置开始处理消息。
kafka满足上面的要求。samza也可以整合其他的message broker系统。
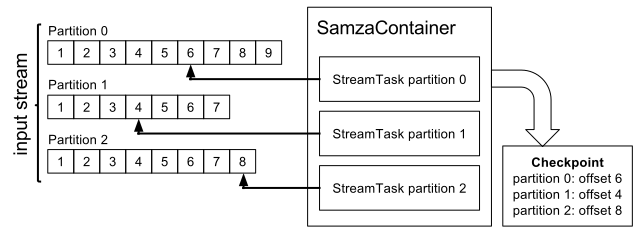
我们描述一下SamzaContainer的处理场景,每个task实例将会消费一个输入流的一个分区,每个task都会保存每个分区当前处理得offset值。每一次处理一个消息,offset将往前移动一位。
如果SamzaContainer失败,需要重新启动能够恢复到处理失败的地方,为了能够做到这一点,需要SamzaContainer能够保存每个task实例当前处理的offset位置。
Checkpoint源码:
at-least-once处理
通过event loop,container定期为每一个任务实例checkpoint——即:记录每个partition的当前offset。
container启动时,它寻找最近的checkpoint,开始从该checkpoint记录的partion的offset处消费消息。如果前面的container 意外失败,checkpoint记录的offset不会移动,最近的checkpoint会落后当前topic的offset(即这个job下次再执行时,可能重复process了一些消息,但是不会错过任何消息)
有些场景下,“at-least-once”这种策略满足不了要求。exact once在后续版本会开发。目前只能通过减少写checkpoint的时间间隔来减少这种影响,可能要以性能开销为代价。配置如下:
如果实时性要求不高,准确性要求比较高,必须实现exact once。利用Camus或者Gobbin将kafka topic落地到HDFS,然后做去重即可。其中Camus可以参考我的另一篇博客Camus介绍。
配置checkpoint
提供两种:FileSystemCheckpointManager and KafkaCheckpointManager
分别将checkpoint存在本地文件中和kafka中
samza会向kafka中写入单独的一个topic–__samzacheckpoint
上述配置的叫:__samza_checkpoint_example-job_1
State Management
状态管理的分类
| 分类 | 是否保留state | 场景 | 类比sql |
|---|---|---|---|
| stateless | 不需要 | 一次处理一条消息、基于某些条件过滤消息 | select … where… |
| stateful | 需要 | Windowed aggregation(ranking, trend detection, count)、Join (Stream-table, Stream-stream) | aggregation和join |
那么,问题来了, 如果保证临时state不丢失?
老的管理任务状态的方法
In-memory state with checkpointing
周期性的把task在内存中的数据做checkpoint. S4的状态管理就是这样做的。
缺点是当作为state的数据量很大时,每次都完全dump所有数据不切实际,如果用diff又太复杂。
Using an external store
把状态写进一个外部的数据库或者key-value store中。
这样数据是不会丢了, 但是明显效率会有问题
而且会产生对其他系统的依赖性
还会影响正确性, 比如当task失败了, 之前的state需要作废, 如何让外部存储上的数据回滚
Samza管理任务的方法——Local state in Samza
samza相当于结合上述两处的优点。
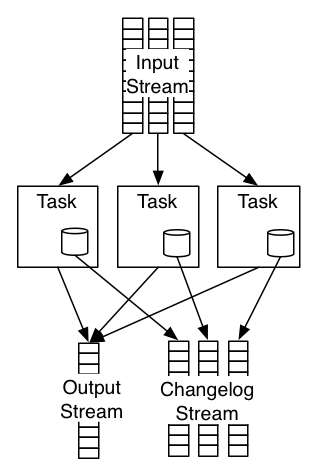
- local:存整个state,但是存在硬盘上。samza采用Key-value数据库存储:RocksDB。每个Task对应一个RocksDB,隔离性高,本地存储吞吐高。
- external:state的change会生成changelog stream放在kafka上。
这样当有task failover的时候, 可以从kafka上读出change log, 并replay出local state
配置
|
|
举例
|
|
Windowing
有些流处理job需要周期执行。
配置
|
|
举例
假设你想报告每分钟pv。每当你看到pv事件,需要增加一个计数。每到一分钟,你当前的计数器值发送到输出流,计数器重置为零。
注意
与process一样,不要在windows()之外使用MessageCollector。
Samza使用单线程执行,所以window()调用不能和一个process()同时发生调用。
- 优势:不需要担心线程安全的代码(没有需要同步)
- 缺点:如果process()方法需要很长时间返回,window()调用可能推迟。
Metrix
当在生产中运行stream process过程,有合理的metrix(度量)来跟踪job的运行是很重要的。Samza提供封装好的metrix库。Samza本身生成消息吞吐量等标准指标,也可以自定义指标。
metrix上报方式
- JmxReporterFactory方式(jvm):
每个容器的指标作为JMX mbean,即通过jmx可以监控,见下节。 - MetricsSnapshotReporterFactory方式(kafka):
reporter每分钟将指标作为消息发送到kafka输出流。输出流用metrics.reporter.*.stream配置12345678910# Define a metrics reporter called "snapshot", which publishes metrics every 60 seconds.metrics.reporters=snapshotmetrics.reporter.snapshot.class=org.apache.samza.metrics.reporter.MetricsSnapshotReporterFactory# Tell the snapshot reporter to publish to a topic called "metrics"in the "kafka" system.metrics.reporter.snapshot.stream=kafka.metrics# Encode metrics data as JSON.serializers.registry.metrics.class=org.apache.samza.serializers.MetricsSnapshotSerdeFactorysystems.kafka.streams.metrics.samza.msg.serde=metrics
默认metrix内容
这个配置,job每隔60秒自动发送几个json编码的消息到kafka的“metrics”话题。像这样的消息:
每个任务实例有一个单独的消息。
- header包括:job名称、job的ID、task分区。
- metrics包括:已处理和发送消息的数量、当前输入流的分区的offset、其他细节。还有上述没有展示出来的:JVM信息(堆大小、垃圾收集信息、线程等),kafka的生产者和消费者的内部指标等
自定义metrix内容
你可以通过MetricsRegistry注册您的自定义指标。需要实现InitableTask流任务,从TaskContext注册表得到指标。
自定义metrix种类:
- counters(计数器):当想要跟踪事物发生的频率
- 仪表(guages):当想要报告事物的level,比如一个缓冲区的大小
- 定时器(timer):当你想要知道代码块花多少时间
counter源码:
这个简单的例子显示了如何计算你的任务处理的消息数量:
|
|
JMX
Samza容器和YARN ApplicationMaster默认支持JMX。可以使用JMX管理JVM;例如,可以使用包含在JDK中的jconsole连接到它。
可以告诉Samza发布其内部指标,你和任何自定义指标定义,作为JMX mbean。需要设置以下属性:
JMX需要配置为使用一个特定的端口,但是在分布式环境中,没有办法提前知道哪些端口可用的机器运行您的容器。因此Samza JMX端口随机选择。如果你需要连接到它,你可以通过容器的日志找到port,报告JMX服务器详细信息如下:
参考:
https://samza.apache.org/learn/documentation/0.10/
https://github.com/feuyeux/hello-samza/blob/master/doc/0.hello_samza.md
http://wdxtub.com/vault/cc-21.html
http://www.infoq.com/cn/articles/linkedin-samza
http://blog.csdn.net/colorant/article/details/12082145
https://wyyhzc.gitbooks.io/hadoop2x/content/samzacontainer.html